PISA-undersøgelsen munder bl.a. ud i en rangliste, der viser, hvordan eleverne i 70 forskellige lande klarer sig. Men forskerne bag testen mangler at redegøre for, hvordan den er blevet skabt.
Det mener den danske statistiker Svend Kreiner fra Institut for Biostatistik på Københavns Universitet.
I et forsøg på at forstå, hvordan modellen virker, har han for nylig genemtrawlet de tekniske rapporter bag testen, der sammenlagt har et omfang på hundredvis af sider.
»Forskerne bag PISA bruger en computermodel til at analysere data, men det er meget uklart, hvordan den arbejder,« siger Svend Kreiner til Videnskab.dk
Den består af en masse delkomponenter, der for udeforstående mest af alt ligner nogle store sorte bokse, som man kaster nogle tal ind i, uden at man kan gennemskue, hvad boksene indeholder og hvad de gør ved tallene. Computermodellens virkemåde ligger altså helt hen i det dunkle. Det er dybt kritsabelt, når nu ranglisten spiller så stor en rolle for udviklingen af uddannelsessystemet,« siger Svend Kreiner.
Køn, alder og social status spiller en rolle
De delkomponenter, der rent faktisk er beskrevet i rapporterne, er Svend Kreiner også skeptisk overfor.
Han kaster sig ud i en gennemgang af modellen i et forsøg på at demonstrere, hvad der er galt:
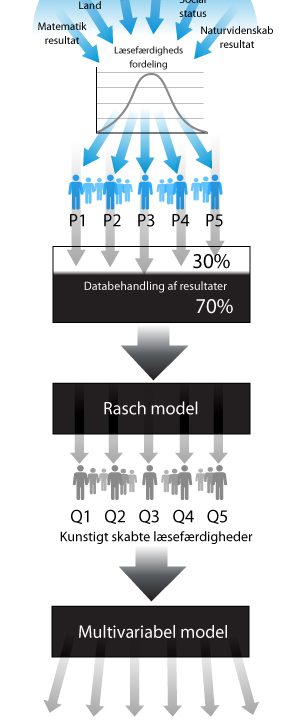
1. Når man har gennemført PISA-testen og har indsamlet elevernes besvarelser i de forskellige lande, så går databehandlingen i gang – det sker ved hjælp af en avanceret computermodel, der er opbygget af forskellige komponenter.
2. Alle elevbesvarelser lagres i en database sammen med oplysninger om elevernes køn, alder, social status. Man antager, at elevernes inteligens i et land følger en normalfordeling, hvor der er få med høj intellligens, få med lav intelligens og mange normalbegavede - en antagelse, som man i sig selv kan stille spørgsmålstegn ved.
De oplysninger kombinerer computeren nu til et tal P, som er et mål for, hvor dygtige eleverne hver især er til at læse.
3. Oplysningerne bliver herefter hældt over i et nyt computerprogram, der er sat i verden for at kompensere for, at PISA-testen kun tester alle elever i ét af de tre fag. PISA-undersøgelsen rummer godt nok altid opgaver inden for både læsning, matematik og naturfag, men hovedfokus ligger på ét af fagene, og det er de færreste elever, der får lov til at besvare opgaver inden for alle tre områder.
Kun 10 procent af deltagerne besvarer alle spørgsmål
I 2006 havde testen f.eks. fokus på naturfag, som samtlige elever blev stillet.
Derudover fik den ene halvdel af eleverne læseopgaver, mens den anden halvdel fik matematikopgaver. Under 10 procent af eleverne er blevet præsenteret for alle opgaver.
»Det er uklart i rapporterne, hvordan PISA håndterer, at ikke alle elever bliver stillet over for den samme test, og at der derfor mangler en masse data på størstedelen af elenerne, og man er derfor overladt til gisninger,« siger Svend Kreiner og giver sig derfor til at gætte:
Én mulighed er, at PISA-forskerne sætter computermodellen til at gætte, hvad eleverne ville have svaret på de enkelte spørgsmål.
En anden mulighed er, at de beder computeren om at konstruere kunstige læsefærdigheder for de elever, der har svaret på læseopgaver, hvorefter de analyserer sammenhængen mellem de kunstige læsefærdigheder og andre variable (deriblandt kunstige færdigheder i matematik og naturfag).
Til sidst konstruerer forskerne kunstige læsefærdigheder for de elever, der slet ikke har løst nogen læseopgaver ud fra oplysningerne om disse elevers kunstige matematik- og naturfagsfærdigheder plus oplysninger om skole, køn, og socioøkonomisk status.
Argumentet for at bruge denne gættemetode er, at det tager for lang tid, hvis alle elever skal svare på alle spørgsmål. Gættemetoden går ud fra, at en dygtig elev i ét fag som regel også er dygtig i alle andre.
Svend Kreiner ved ikke, hvilken af ovenstående fremgangsmåder, PISA-forskerne har valgt, fordi modellen på dette punkt kun er beskrevet i meget overfladiske vendinger i de tekniske rapporter
»Men jeg vil skyde på, at de har brugt den første. Uanset hvilken af de to modeller, forskerne har valgt, så er det betænkeligt, at computeren gætter sig frem. Disse gæt er det fundament, som ranglisten siden hen står på,« siger Svend Kreiner.
70 procent af dataene er computerskabt
Af de tal, der kommer ud på den anden side af boksen, er det kun 30 procent, der stammer fra elevernes reelle svar – de resterende 70 procent er altså frembragt ved at computermodellen på den ene eller den anden måde har gættet sig frem på baggrund af forskellige oplysninger om eleven.
Outputtet af modellen er nogle kunstigt skabte læsefærdigheder, som dog ikke har nogen fysisk betydning. Tallene kan altså i realiteten ikke beskrives eller forklares – de er blot meningstomme tal, som modellen arbejder videre på,« siger Svend Kreiner.
Det sidste skridt i processen går ud på at sende tallene over i en ny såkaldt 'multivariabel' model, der er designet til at give de enkelte lande point og placere dem på en rangstige.
Hvordan modellens sidste led virker står heller ikke beskrevet i rapporterne.
Man kan alligevel teste, om modellen arbejder rigtigt, fordi computeren burde skabe den samme rangliste uanset hvilken opgave, man lod modellen regne på. Men det krav lever computermodellen ikke op til.
»Hvis jeg bruger de opgaver, som danske elever af ukendte årsager har lettere ved at besvare end elever i andre lande, så rykker Danmark op i toppen af ranglisten - hvis jeg bruger de opgaver, som danske elever har sværere ved, så ryger vi ned i bunden af listen. Det siger sig selv, at begge dele ikke kan være sandt, så der er noget helt galt med modellen,« konkluderer han.